Strata · 追踪报道(共 3 篇)
- Strata 0.2 测试版发布:性能升级,门槛再降低|低配电脑运行本地大模型 (当前文章)
- Strata 现已支持 macOS,还能运行更轻量的 Qwen3.6-35B-A3B 大模型了
- 8GB显存就够,Strata 让普通电脑也能运行千亿参数大模型
- Strata 0.2 测试版发布:性能升级,门槛再降低|低配电脑运行本地大模型 (当前文章)
- Strata 现已支持 macOS,还能运行更轻量的 Qwen3.6-35B-A3B 大模型了
Strata 是一款让普通家用电脑运行本地 AI 大模型的开源工具,可运行 Qwen3.8-Flash-Next、Qwen3.6-35B-A3B 等大模型,并拥有相当流畅的推理速度。@Appinn
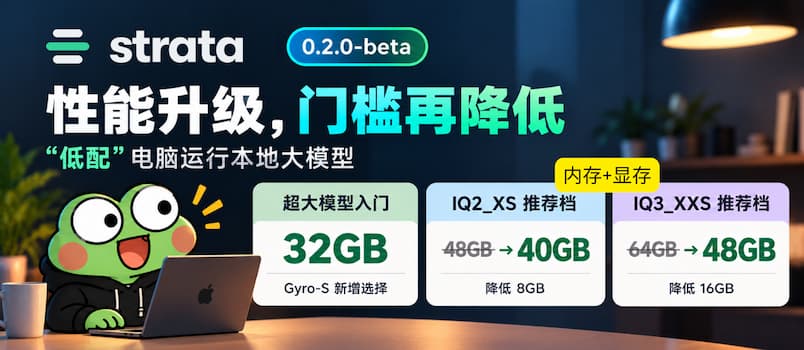
昨日,Strata 0.2.0 测试版发布,再次降低了使用门槛,内存+显存合计最低只需要 27.6GB 即可运行本地大模型。
| 超大模型入门 | IQ2_XS 推荐档 | IQ3_XXS 推荐档 |
|---|---|---|
| 32GB |
|
|
| Gyro-S 新增选择 | 降低 8GB | 降低 16GB |
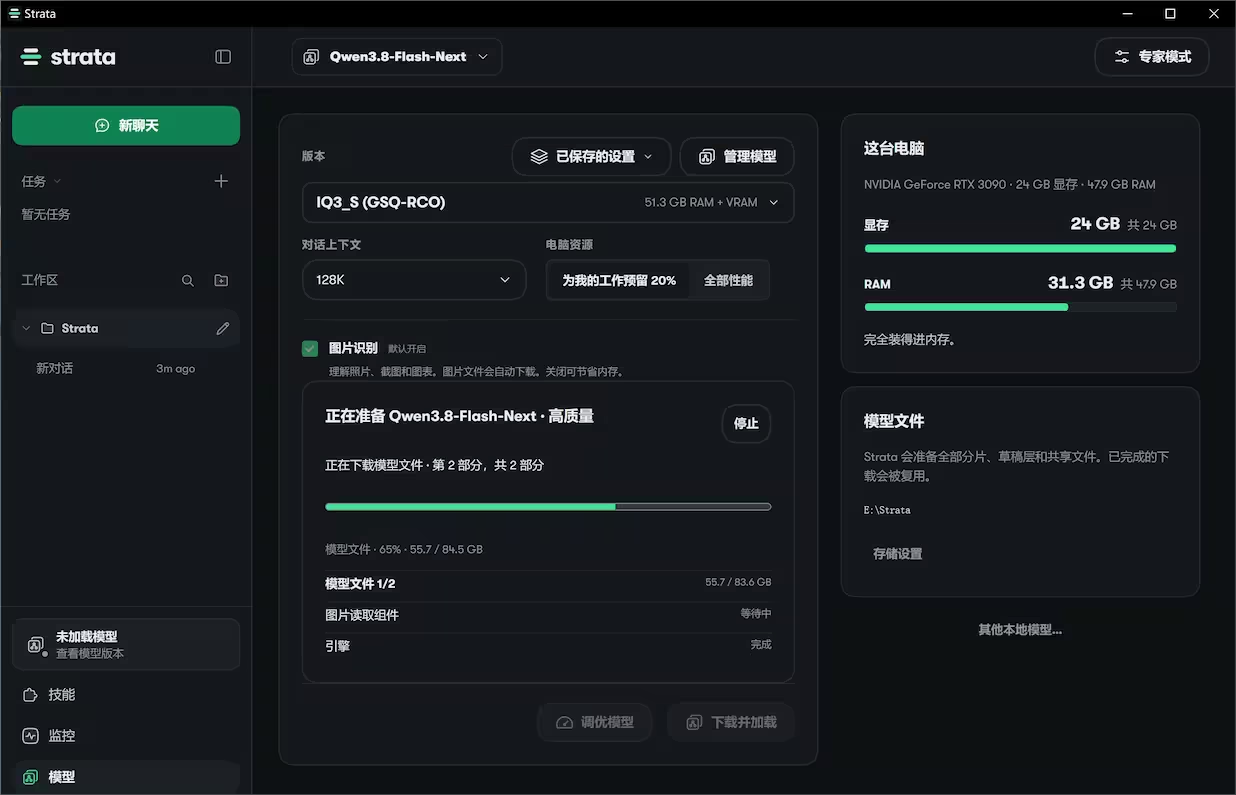
现在还拥有了独立的图形界面,Windows、macOS 和 Linux 用户可以直接下载安装,并有使用向导、模型推荐,无需再通过命令行编译部署。
推理性能再次得到优化:
- NVIDIA RTX 30 系列显卡,文本生成速度最高提升约 13%(官方 RTX 3060 实测提升 10.2%,RTX A4000 提升 13%)。
- AMD RX 9000 系列显卡,部分模型的提示词处理速度接近翻倍。
- Intel Arc 显卡也获得加速,A750 的提示词处理速度提升约 42%。
Strata 0.2.0 更新前后模型推荐对比
Strata 明确是 RAM + VRAM 的内存需求,也就是说,如果你有一块 12GB 显卡,最低只需要 20GB 内存就能跑起来了。
| 内存+显存 | 旧版推荐 | 0.2.0 新版推荐 | 变化 |
|---|---|---|---|
| 32GB | 35B-A3B Q4 | Flash-Next Gyro-S | 进入超大模型入门档 |
| 40GB | 35B-A3B Q4 / Q6 | Flash-Next Swift 1.5 IQ2_XS | 原需 48GB |
| 48GB | Flash-Next IQ2_XS | Flash-Next IQ3_XXS | 原需 64GB |
| 64GB | Flash-Next IQ3_XXS / IQ3_S | Flash-Next IQ3_S / Swift 1.5 IQ3_S | 高质量档更加成熟 |
| 96GB+ | Flash-Next UD-IQ4_XS | Flash-Next UD-IQ4_XS | 基本不变 |
Strata 0.2.0-beta 最明显的变化,是同样的硬件配置有了更好的模型选择:
- 32GB 即可尝试 Flash-Next 的 Gyro-S 量化版
- 40GB 进入 IQ2_XS 推荐档位
- 48GB 则可以选择原本建议 64GB 的 IQ3_XXS
而针对不同模型,性能大概是这样的:
| 模型 | 量化版本 | 推荐配置 | 模型特点 |
|---|---|---|---|
| 35B-A3B | UD-Q4_K_XL | 32GB | 体积小,推荐入门 |
| 35B-A3B | UD-Q6_K_XL | 44GB | 精度更高 |
| 35B-A3B | Q8_0 | 52GB | 高精度,资源需求较大 |
| Flash-Next | Gyro-S | 32GB | 超低内存入门,质量有所妥协 |
| Flash-Next | Q2_0 | 约 40GB | 低位量化,偏重速度 |
| Flash-Next | Swift 1.5 IQ2_XS | 40GB | 官方推荐,兼顾速度和质量 |
| Flash-Next | Gyro-M | 约 40GB | 低内存选择,运行可能较慢 |
| Flash-Next | IQ3_XXS | 48GB | 质量更好,推荐配置降低 |
| Flash-Next | IQ3_S | 64GB | 高质量推荐 |
| Flash-Next | Swift 1.5 IQ3_S | 64GB | 高质量,减少推理思考开销 |
| Flash-Next | UD-IQ4_XS | 96GB 及以上 | 约 4-bit,更接近原始模型 |
青小蛙也正在升级,因为此前使用的模型是 Strata 推荐的 IQ2_XS,而这次升级之后,官网也将推荐模型提升了一个档次,这次推荐的是 IQ3_XXS 尺寸。
但是也遇到了新的问题:下不动 😭
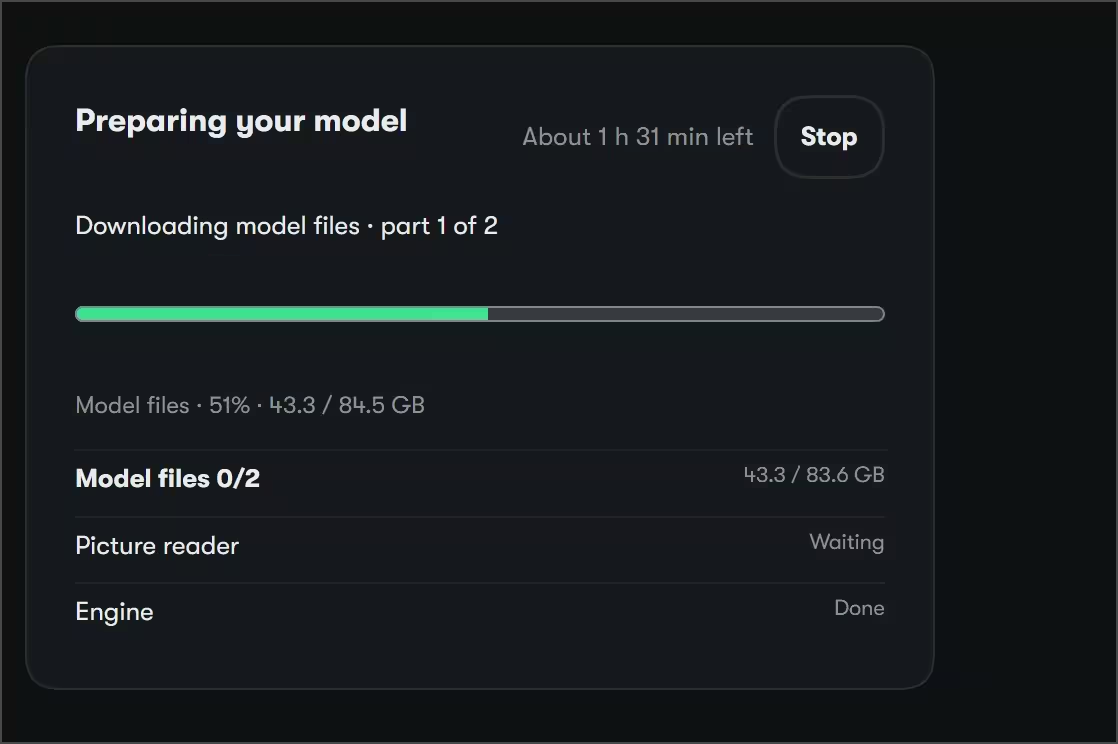
所以暂时无法体验速度。
其他升级
有中文界面了:
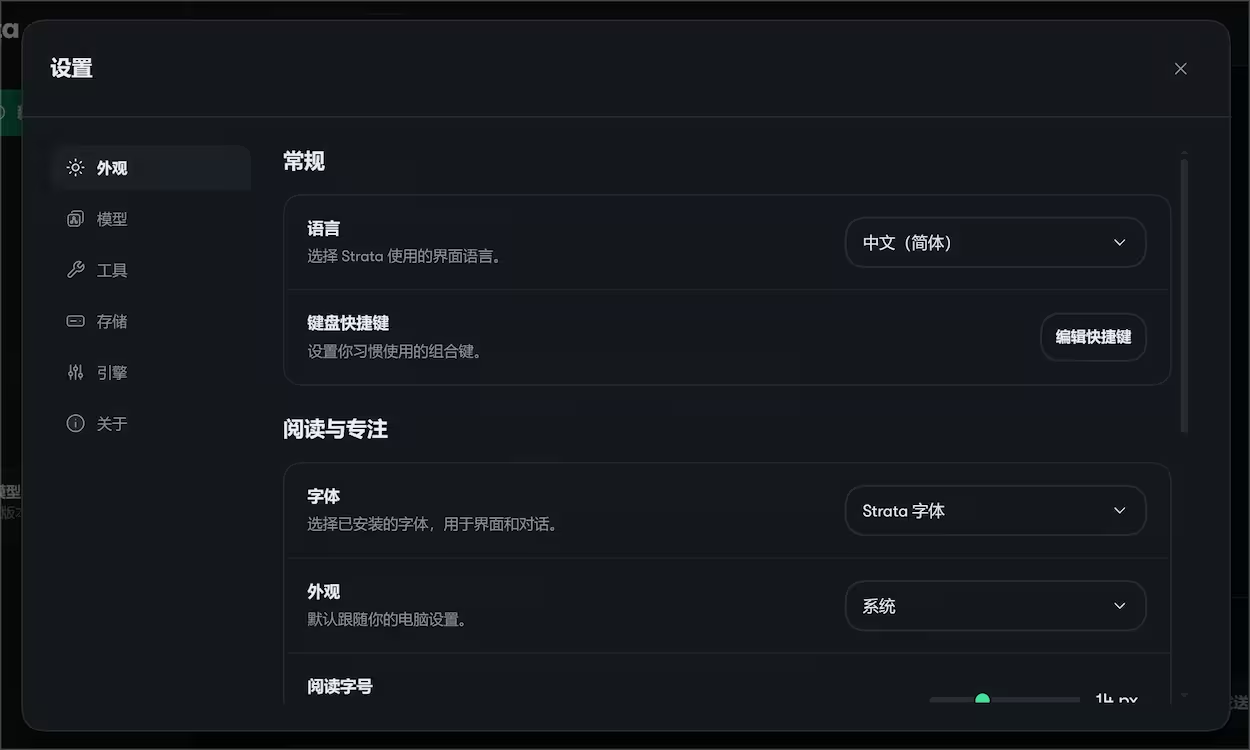
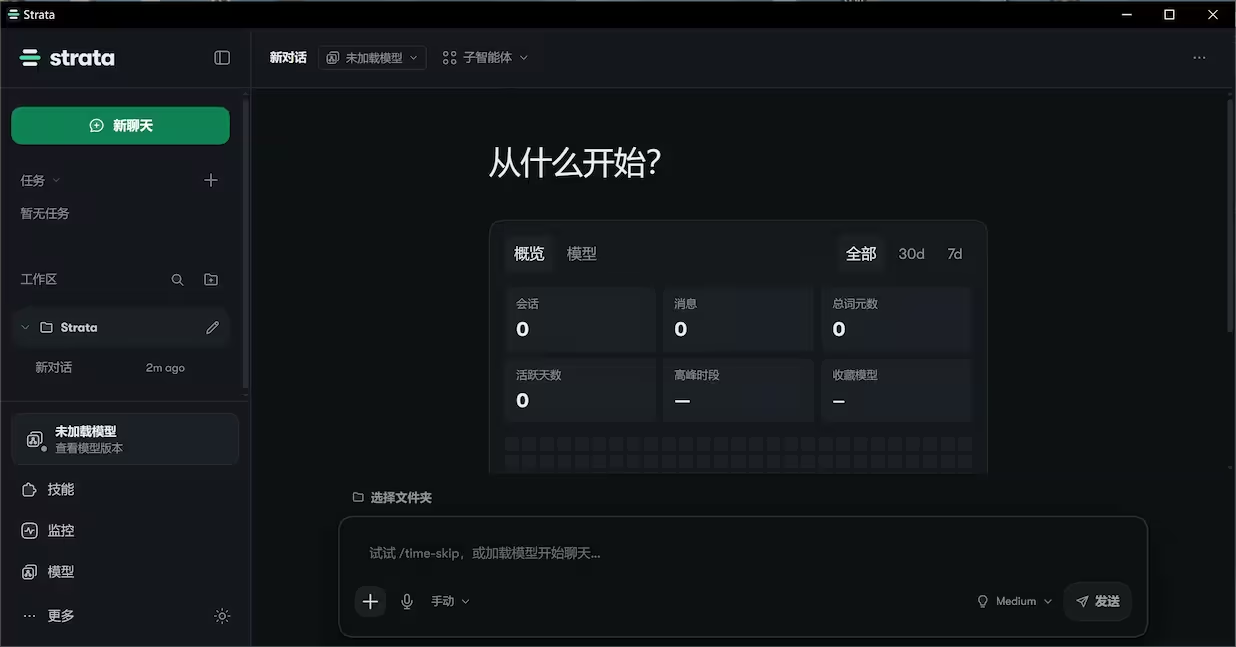
新版 Strata 还在图形界面中集成了 AI 编程 Agent,支持读取、创建和修改文件、联网搜索,以及自动执行任务。
另外,NVIDIA 和 AMD 显卡现在默认支持图片理解,模型下载也进行了优化,支持多连接并发、断点续传和文件完整性校验。
下载速度这一点上,虽然但是啊,该慢还是慢 😭
获取
新安装的同学注意,它会自动安装到 C 盘,不容你修改。不过数据盘可以修改
升级的同学,和重装没什么区别,可以选择原模型,但它升级了性能,你可以更换更好的模型了。
原文:https://www.appinn.com/strata-0-2-beta/
给大模型瘦身:不同量化版本
大模型之所以叫大,就是因为真的大。
于是,给大模型瘦身这件事,被称作量化。
通过降低模型参数的存储精度,可以大幅缩小模型体积,不同的参数,就有了不同的量化版本。IQ2_XS、IQ3_XXS、IQ3_S 都是大模型的量化版本。
它们的区别主要在于压缩程度:
| 量化版本 | 压缩程度 | 内存占用 | 模型质量 |
|---|---|---|---|
| IQ2_XS | 约 2-bit,压缩率最高 | 最低 | 相对较低 |
| IQ3_XXS | 约 3-bit,高压缩 | 中等 | 较好 |
| IQ3_S | 约 3-bit,保留更多精度 | 较高 | 更好 |
其中,IQ 是 llama.cpp 的一种重要性感知量化格式,数字 2、3 大致代表每个模型权重使用的比特数;XS、XXS、S 则表示不同的量化配置。
可以把它理解为图片压缩:压缩得越狠,文件越小,但也更容易损失细节。
对于普通用户,记住一个原则:选你内存限制内最大的量化版本即可。